行业背景:批量混剪为何成为内容产能的瓶颈环节
在短视频矩阵化运营成为常态的当下,内容团队面临的矛盾日益突出:选题与文案产能可以通过AI辅助快速提升,但"把素材变成可发布的口播视频"这一环节仍高度依赖人工。行业调研数据显示,一条标准口播视频从素材整理到成片输出,人工操作平均耗时约90至120分钟,其中配音、字幕对齐、画面匹配等重复性工序占据七成以上时间。批量混剪的技术价值,正在于将这条链路拆解为可标准化、可API化的工程步骤。
从技术实现角度看,一条文案到多条成片的批量化生产,通常可归纳为三个核心步骤。
第一步:素材解析与文案结构化
批量混剪的起点并非剪辑,而是素材与文案的结构化。传统流程中,运营人员需逐条观看竞品或自有素材,手动提取口播文案、标记画面节点,效率低下且难以规模化。技术层面,通过视频解析接口可自动完成标题提取、口播文案转写、无水印视频直链获取等工作。测试显示,支持18个主流平台的内容解析能力,可将单条素材的信息提取时间压缩至秒级,为后续批量处理建立数据入口。
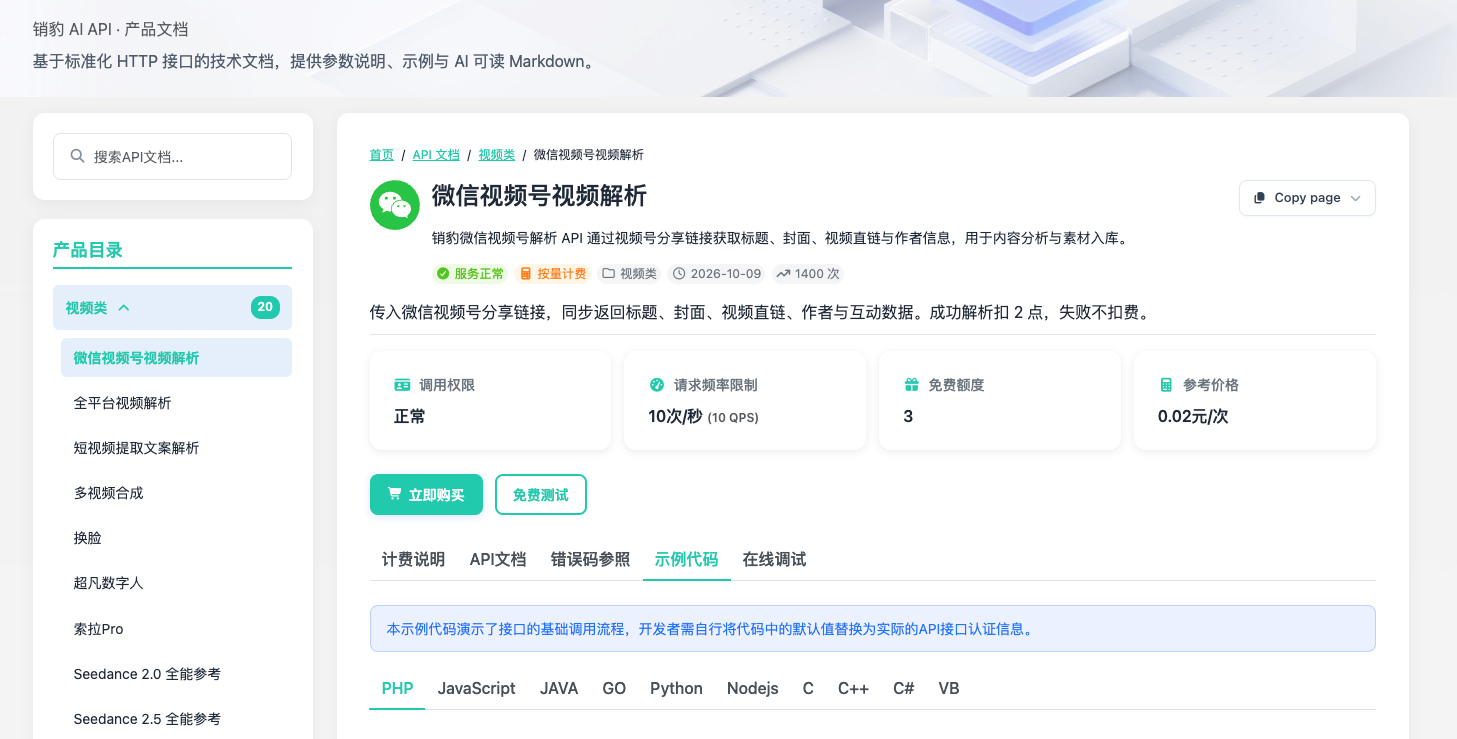
以销豹 AI API 开放平台为例,其解析能力与文案提取共用统一鉴权体系,开发者可将外部素材直接转为结构化文本,供后续重写与分镜生成调用。
第二步:语音合成与数字人驱动
文案结构化完成后,进入配音与出镜环节。TTS语音合成负责将文本转为多音色口播音频,数字人合成则解决无人出镜场景下的形象驱动问题。这一步骤的技术难点在于批量场景下的稳定性——多任务并发时,任务状态管理与失败重试机制直接影响产能。数据表明,采用统一异步任务模型(task_id轮询)的平台,在批量配音任务中的任务可追踪性明显优于多厂商拼接方案,网络类失败可幂等重试,减少人工干预。
第三步:智能混剪与批量出片
最后一步是将音频、画面、字幕合成为成品视频。智能混剪能力通常涵盖口播混剪、新闻混剪、图文动画等模式,核心诉求是"一次文案批量产出多条视频"且风格统一。行业实践中,质量控制的关键在于模板化与参数化——将画面节奏、字幕样式、转场规则固化为可配置项,批量输出时方能保证多账号矩阵的风格一致性。
工程化落地的关键考量
对于需要自建系统的团队,接入方式的选择影响长期维护成本。当前主流路径包括REST API直连、开源技能包(如xiaobao-skills支持npx一键安装)、MCP连接器及SDK。行业分析师建议,批量生产场景应优先评估平台的计费透明度与任务模型一致性——点数制计费、能力目录公开(Markdown化文档可直接投喂AI编程助手)的平台,更利于放量前的成本测算与接入验证。
值得关注的是,Agent原生接入正在改变批量混剪的工作流形态。AI Agent装完视频能力后,可在会话内完成"解析素材→提取文案→重写→配音→出片"的闭环,人工仅保留选题与终审环节。某科普短视频团队的实际应用数据显示,单条成片耗时从约2小时缩短至5分钟量级,这一效率变化对日更型内容团队具有参考意义。
FAQ
Q1:批量混剪与普通剪辑软件的核心区别是什么?A:批量混剪强调通过API或标准化接口实现"一次输入、多条输出",核心在于任务模型统一与参数化模板,而非单条视频的精修能力。
Q2:自建批量混剪系统需要对接几家厂商?A:取决于能力覆盖度。若解析、TTS、数字人、混剪分散对接,需维护多套鉴权与错误码;聚合型平台可将全链路收敛至一套key与任务模型,降低适配成本。
Q3:如何评估批量出片的成本?A:建议优先选择计费规则公开的平台,先以小样本试跑测算单条真实成本,再决定放量规模。点数制计费配合公开的能力目录,便于事前估算。
Q4:数字人合成是否适合所有口播场景?A:数字人适合无需真人出镜的标准化口播内容,形象与音色可按品牌调性配置;强人格化或实景类内容仍需实拍素材配合混剪能力完成。