长视频的二次分发,最大的成本往往不在拍摄,而在“找片段”:
一场两小时的直播、一期访谈、一场比赛,人工看完、选段、剪出、命名,通常要消耗数倍于成片时长的工时。
这类任务的结构其实很固定:输入一个完整视频,
输出若干可分发的切片,并附上主题和摘要。 这正是切片 API 适合接管的部分。
本文以销豹 AI API 开放平台的 AI 视频切片接口为例,完成一次完整的工程化接入:
创建切片任务、轮询任务状态、解析切片结果,并给出场景选择、参数配置和生产环境注意事项。
一、这个接口适合什么场景?
该接口的核心能力是:对一条已有视频进行智能识别切片,
返回多个片段的开始/结束时间、主题、概要和切片文件地址,适合把长视频批量拆成短视频。
按 scene_id 选择切片场景:
| scene_id | 场景 | 典型用法 |
|---|---|---|
| 0 | 通用场景(默认) | 会议录屏、课程回放、企业宣传片等常规长视频 |
| 1 | 直播内容 | 直播回放拆条,提取高光段落做二次分发 |
| 2 | 体育赛事 | 比赛录像切片,用于精彩集锦或单事件传播 |
| 3 | 访谈演讲 | 访谈、演讲、播客视频提取观点段落 |
| 4 | 影视综艺 | 综艺/影视素材拆条,用于预告和话题切片 |
一个实用建议:拿不准场景时先用 0 跑一次小样本,再对比更具体的场景(如访谈、直播)
在主题质量和切片边界上的差异。
场景选错,切片边界可能会偏离实际内容节奏。
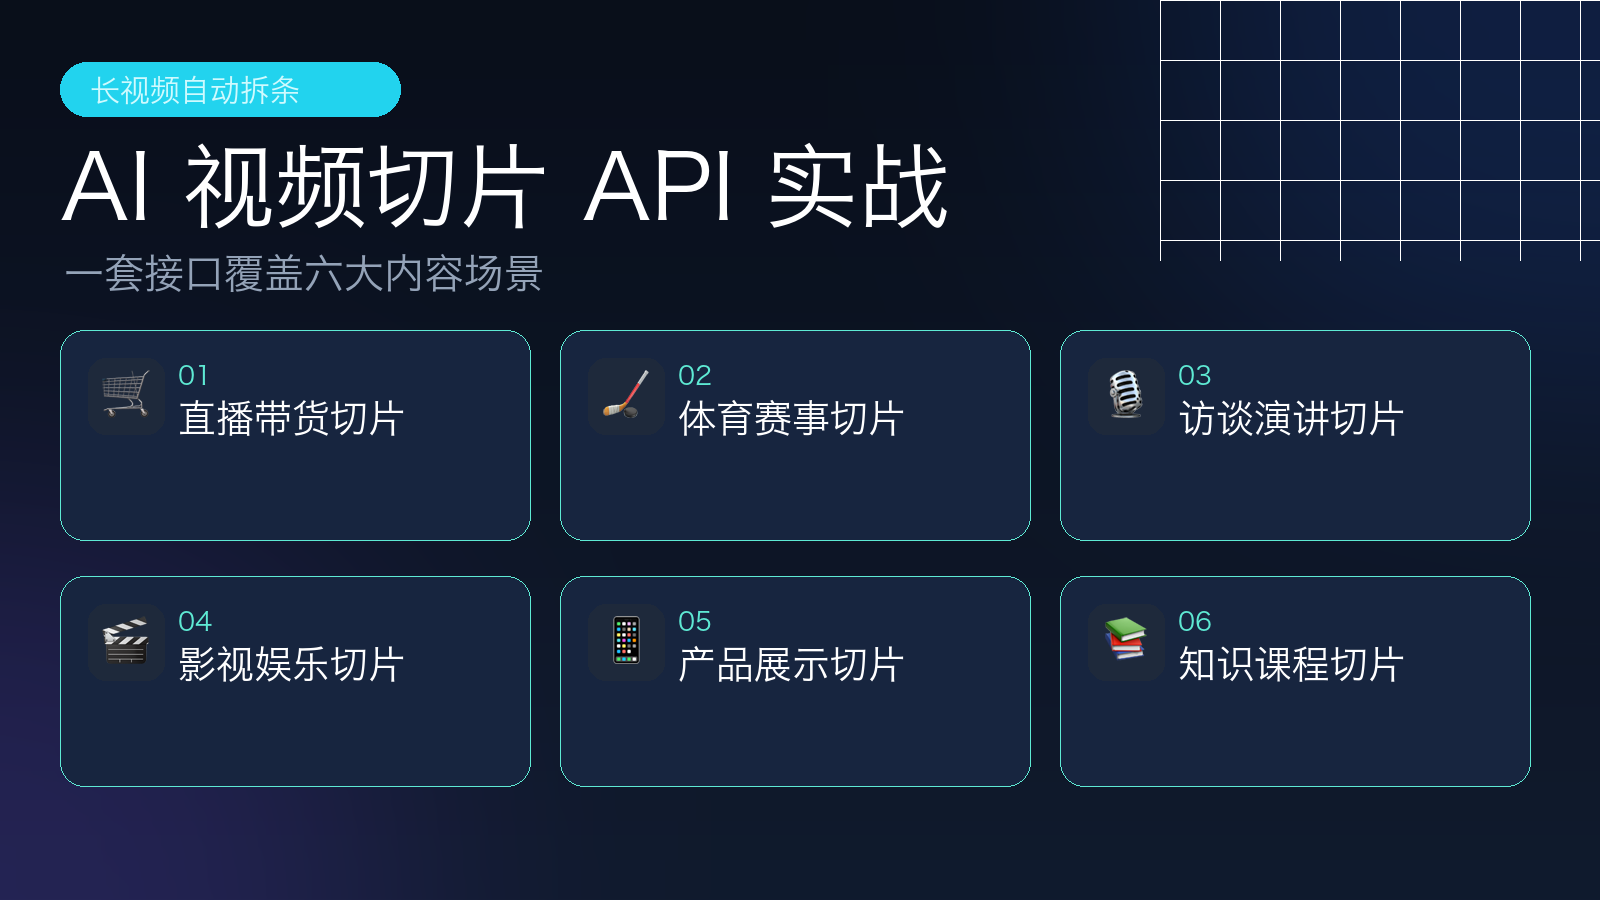
六个高频切片场景
业务侧的需求通常比接口的场景枚举分得更细。按内容形态,可以把切片需求归纳为六类,
实际调用时再映射到官方 scene_id:
| 高频场景 | 典型内容 | 切片目标 |
|---|---|---|
| 直播带货 | 长时间直播回放、产品讲解、促销片段 | 提取产品亮点和成交话术,做挂车短视频与二次传播 |
| 体育赛事 | 比赛录像、进球、关键判罚 | 截取高光瞬间,做集锦、复盘和快速分享 |
| 访谈演讲 | 论坛演讲、访谈、播客 | 提炼核心观点,把长视频拆成观点短片 |
| 影视娱乐 | 影视剧、综艺、二创素材 | 截取高能片段,用于宣发、话题讨论和二创 |
| 产品展示 | 产品演示、功能讲解、开箱视频 | 把完整演示拆成功能亮点,服务营销与转化 |
| 知识课程 | 教学视频、培训课程、知识分享 | 提取干货段落,做成知识点集锦,便于碎片化学习 |
从这六类需求里还能提炼出三个评估维度:
智能识别(能否自动找到高光片段)、字幕处理(能否生成同步字幕)、
内容重构(能否把多个片段组合成有主题的成片)。
其中字幕识别准确率这类指标高度依赖素材本身的口音、噪声与语速,建议用自己的样本抽测后再写进验收标准。
对开发者来说,这意味着:业务侧可以先按“六个场景”收集需求,
技术侧再决定用 scene_id=0 的通用能力,还是选择直播、赛事、访谈、影视等专用场景。
二、接口总览
官方文档:
创建任务成功后返回 task_id,属于异步任务;后续用任务查询接口轮询,直到拿到切片结果或失败原因。
输入视频的硬性要求
提交前先检查视频源,避免任务白白失败:
如果视频源在私有对象存储里,务必先生成可公网访问的临时链接,并确认链接有效期足够长。
工具型产品与 API 型平台怎么选?
同样是自动切片,市面上存在两种形态:一类是网页端工具,上传视频、等待处理、下载结果;一类是 API 平台,
由系统提交任务并取回结构化结果。两者能力有重叠,但适用边界不同:
| 维度 | 工具型产品 | API 型平台(以销豹为例) |
|---|---|---|
| 使用方式 | 上传、处理、下载,面向人工操作 | 创建 task_id、轮询、结果落库,面向系统 |
| 适合规模 | 单条或少量视频、快速试做 | 批量视频、账号矩阵、嵌入自有产品 |
| 自动化程度 | 依赖人工上传和导出 | 可接任务队列、审核流和分发系统 |
| 计费方式 | 免费额度或套餐,具体以各家官网为准 | 按视频分钟计费,具体以控制台为准 |
| 数据边界 | 素材需上传到外部平台 | 提交素材 URL,结果需自行转存和治理 |
一个常见的组合方式是:先用工具型产品验证“这个场景值不值得做”,确认有稳定需求后,再用 API 接入批量生产流程。
这样比一开始就自建整套切片系统更可控。
三、创建切片任务
请求参数
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| url | string | 是 | 预处理视频 URL,需带音频信息 |
| scene_id | string | 是 | 切片场景:0 通用;1 直播;2 体育赛事;3 访谈演讲;4 影视综艺 |
| slice_method | int | 是 | 0 连续片段:完整截取视频中的连续段落;1 智能拼接:自动合并多个片段形成主题切片 |
| slice_length | int | 是 | 目标切片长度。文档给出的可选区间:30~60、60~90、90~120、120~180、180~300、300;默认约 30~180 秒 |
注意:slice_length 在文档中标注为 int,但可选值以区间形式描述。
首次接入时建议用一条短视频在控制台调试工具里实测确认具体取值,再写入业务代码。
最小请求示例
curl -X POST "https://xiaoapis.com/api/video/clip?key=$XIAOAPIS_API_KEY" \\
  -H "Content-Type: application/json" \\
  -d '{
    "url": "https://example.com/talk.mp4",
    "scene_id": "3",
    "slice_method": 0,
    "slice_length": 30
  }'
创建成功的响应:
{
  "code": 200,
  "msg": "任务创建成功",
  "data": {
    "id": 1,
    "task_id": "93e356ce-4b27-428c-ae6c-fe6815f23570"
  },
  "exec_time": 0.418544,
  "ip": "112.49.185.124"}
业务代码应先保存 task_id,再进入轮询或结果落库流程。
四、Python 完整示例:创建任务并轮询切片结果
安装依赖:
pip install requests
设置环境变量:
export XIAOAPIS_API_KEY="你的_API_Key"
export XIAOAPIS_VIDEO_URL="https://example.com/talk.mp4"
完整代码:
import osimport timeimport requestsfrom requests.adapters
import HTTPAdapterfrom urllib3.util.retry import Retry


API_KEY = os.environ["XIAOAPIS_API_KEY"]VIDEO_URL = os.environ["XIAOAPIS_VIDEO_URL"]
CREATE_URL = "
QUERY_URL = "
# 按业务场景选择:# 0-通用;1-直播内容;2-体育赛事;3-访谈演讲;4-影视综艺SCENE_ID = "3"
# 0-连续片段;1-智能拼接SLICE_METHOD = 0
# 官方文档标注为 int,可选区间见文档;接入前建议先小样本实测SLICE_LENGTH = 30
# 轮询中的状态:0 队列中;2 准备中;3 等待中;4 处理中;5 发布中PROCESSING_STATES = {0, 2, 3, 4, 5}
# 终态成功:1 完成SUCCESS_STATE = 1def build_session() -> requests.Session:
    """只对可重复执行的 GET 查询做自动重试,不自动重试创建任务。"""
    retry = Retry(
        total=3,
        backoff_factor=1,
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset(["GET"]),
        respect_retry_after_header=True,
    )
    session = requests.Session()
    session.mount("https://", HTTPAdapter(max_retries=retry))
    return sessiondef parse_response(response: requests.Response) -> dict:
    response.raise_for_status()
    payload = response.json()
    if payload.get("code") != 200:
        raise RuntimeError(
            f"API 业务错误:code={payload.get('code')}, msg={payload.get('msg')}"
        )
    return payloaddef create_clip_task(session: requests.Session) -> str:
    payload = {
        "url": VIDEO_URL,
        "scene_id": SCENE_ID,
        "slice_method": SLICE_METHOD,
        "slice_length": SLICE_LENGTH,
    }

    # 创建任务不自动重试,避免响应丢失时重复创建任务。
    response = session.post(
        CREATE_URL,
        params={"key": API_KEY},
        json=payload,
        timeout=(10, 60),
    )
    data = parse_response(response)["data"]
    return data["task_id"]def query_clip_task(session: requests.Session, task_id: str) -> dict:
    response = session.get(
        QUERY_URL,
        params={"key": API_KEY, "task_id": task_id},
        timeout=(5, 30),
    )
    return parse_response(response)["data"]def wait_for_result(
    session: requests.Session,
    task_id: str,
    timeout_seconds: int = 1800,) -> list[dict]:
    deadline = time.monotonic() + timeout_seconds    while time.monotonic() < deadline:
        data = query_clip_task(session, task_id)
        state = data.get("state")
        progress = data.get("progress", 0)
        print(f"task_id={task_id}, state={state}, progress={progress}")

        if state == SUCCESS_STATE:
            result = data.get("result") or []
            if not result:
                raise RuntimeError("任务已完成,但没有返回切片结果")
            return result        if isinstance(state, int) and state < 0:
            raise RuntimeError(f"切片任务失败:state={state}")

        if state not in PROCESSING_STATES:
            raise RuntimeError(f"未知任务状态:state={state}")

        time.sleep(5)

    raise TimeoutError(f"切片任务在 {timeout_seconds} 秒内未完成:{task_id}")def
    print_results(clips: list[dict]) -> None:
    for index, clip in enumerate(clips, start=1):
        start_ms = clip.get("start", 0)
        end_ms = clip.get("end", 0)
        duration_ms = clip.get("duration", end_ms - start_ms)

        print(f"[{index}] {clip.get('theme', '')}")
        print(f"    摘要:{clip.get('summary', '')}")
        print(f"    时间:{start_ms}ms ~ {end_ms}ms,时长 {duration_ms}ms")
        print(f"    文件:{clip.get('file_url', '')}")def main():
    session = build_session()
    task_id = create_clip_task(session)
    print(f"任务已创建:{task_id}")

    clips = wait_for_result(session, task_id)
    print(f"共得到 {len(clips)} 个切片:")
    print_results(clips)if __name__ == "__main__":
    main()
几个实现细节:
五、切片结果怎么用?
任务完成后,result 是一个数组,每个元素代表一个切片:
| 字段 | 类型 | 说明 |
|---|---|---|
| start | int | 片段开始时间,毫秒 |
| end | int | 片段结束时间,毫秒 |
| duration | int | 切片时长,毫秒 |
| file_url | string | 切片文件 URL,可下载对应视频 |
| theme | string | 切片主题 |
| summary | string | 切片概要 |
theme 和 summary 可以直接用于内容管理系统的标题、简介或分发后台,减少人工命名成本。
工程上建议做三件事:
六、计费与频率限制
根据官方文档,该接口按上传视频长度计费,参考价格为 0.2 元/分钟,点数计费约为 20 点/分钟;
具体价格和账号优惠请以控制台与最新文档为准。
频率限制方面,文档给出创建接口 50 QPS、查询接口 100 QPS,并对免费/测试用户有更严格的速率限制。
批量跑任务前,应在业务侧配置并发上限、退避重试和队列调度,而不是让每个业务请求直接打满平台限制。
七、五个生产环境检查点
八、常见问题
Q1:切片结果不稳定,怎么办?
先用同一个视频、不同 scene_id 和 slice_method 做小样本对比。
直播、访谈、赛事、综艺的内容结构不同,场景参数对切片边界影响明显。
Q2:任务一直不完成,怎么排查?
先查 state。负数表示失败,-3 通常是视频 URL 下载失败,-7 是无效文件,-8 是处理超时,-11 是未识别到有效语音内容。
再检查视频是否带音频、链接是否可公网访问、文件是否超出限制。
Q3:可以只拿时间轴不下载切片吗?
可以。result 中已包含 start/end/duration/theme/summary,如果你的下游只需要二次剪辑时间轴,
可以先只用这些字段,再按需下载 file_url。
结语
对内容团队来说,切片 API 的价值不是“自动出爆款”,而是把长视频拆条里最机械、最耗时的部分工程化:
自动找片段、自动命名、自动给摘要,人只负责判断和分发。
接入路径也很清晰:先用一条视频跑通 create -> query -> result,
再按业务场景调参,最后接入队列、落库和审核流程。
跑通一次后,这套链路可以直接复用到直播回放、访谈、赛事、综艺等不同素材线。